打开任何一家 BI 厂商的官网,几乎都能看到一个"对话问数"的入口。IDC 的数据显示,2025 年中国 BI 市场里具备 AI 对话分析能力的产品占比已经超过 70%,这个功能早就不稀缺了。
可真正被用起来的并不多。2026 年的一项调研显示,90% 已部署 ChatBI 的企业里,业务部门实际使用率不足 30%,活跃使用率不足业务总人数的 20%;观远数据调研的 300 家规模以上企业,上线三个月后周均使用率不足 15%,八成以上最后成了摆设。
口径不一致、数据没准备好、组织不参与,这些原因大家都讲过。这里想说一个更容易被忽略的:采购时看的是决策层的演示,上线后用的却是一线业务。
一、先确认这套系统主要给谁用
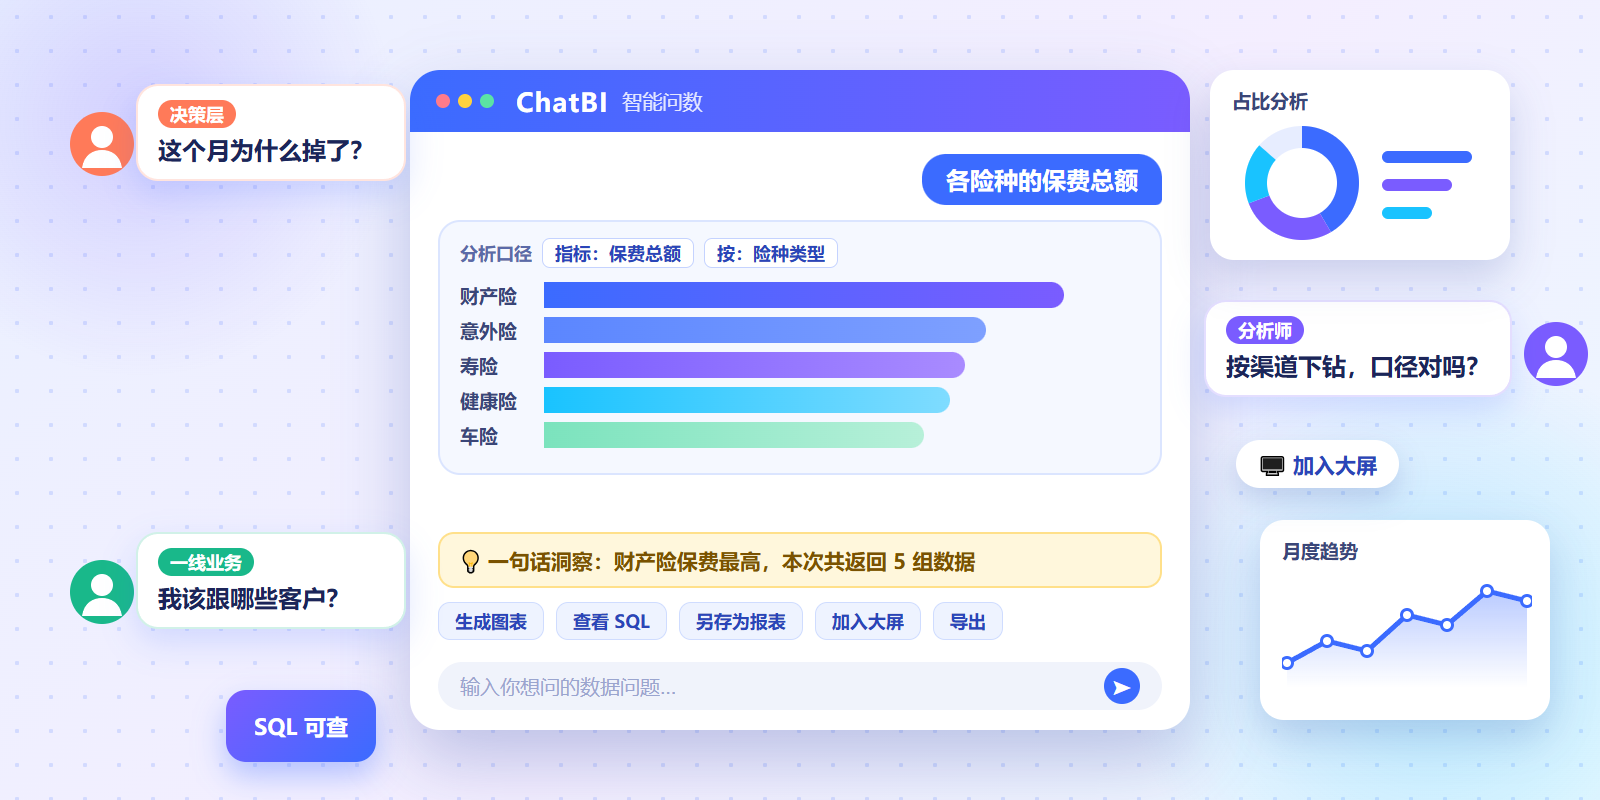
同样叫智能问数,三类提问者的需求几乎不重叠。
决策层要的是结论和判断。"这个月为什么掉了"——要原因分析和建议,不要明细数据。提问频率低,但每次深度要求高。
分析师要的是明细和口径准确。会追问、会下钻、会拿数去交叉验证。对他们的容错率极低,错一次就不再信。
一线业务要的是动作。"我这个区域哪些客户要跟进"——要能直接干活的清单,不需要图表和分析框架。提问频率高,但问题简单、重复。
三类的共同点只有一个:都要随手能问。差别在深度、频率和容错率。
二、六家分别服务哪一类
排序依据说明:不打分。按公开能力侧重、主要服务的提问者、POC 可核对的事实项排序,同一类内按能力覆盖度排列。
第 1 位|JimuChatBI(积木问数):三类提问者都能接,重心是"先建模、再问数"
JimuChatBI(又叫 Chat2BI)是积木报表的对话式 BI 模块。业务人员不用懂 SQL、不用画报表,像聊天一样提问,AI 自动理解问题、生成查询、取数,再以表格 + 图表 + 一句话洞察返回。它把链路拆成"数据源 → AI 数据表 → 数据域(语义建模)→ 对话助理 → 用户问数"五个概念,前四步由管理员配好,最后一步交给业务用户。
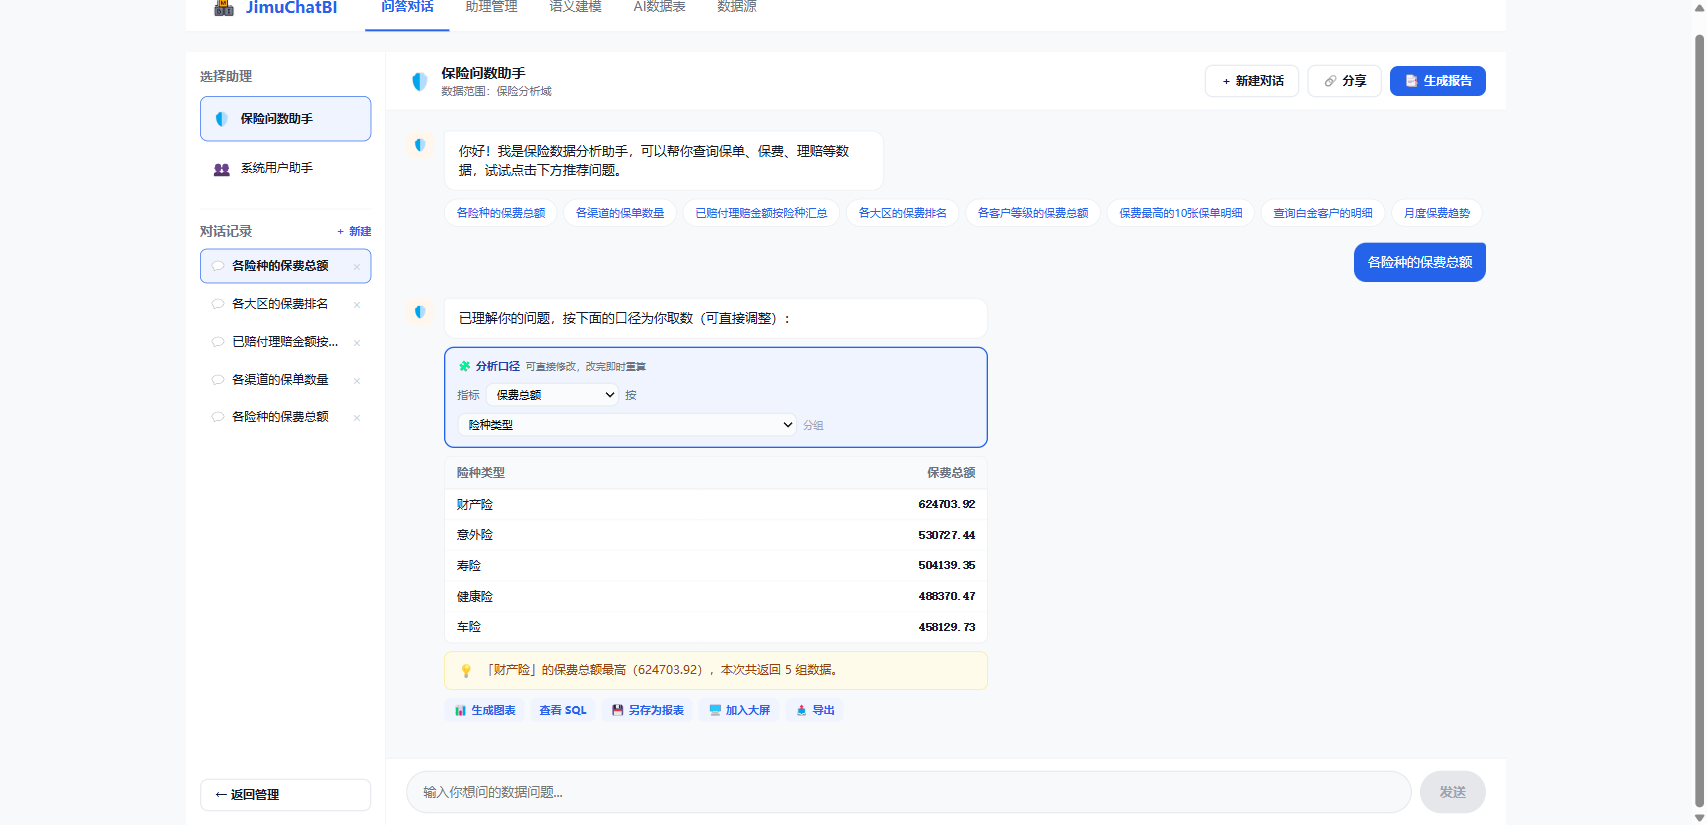
对分析师:口径靠语义建模统一管起来。数据域里可以注册表、配置关联、打包查询主题,还有术语管理——把业务口语、简称、近义词映射成精确口径,既可以只做释义,也可以固定时间口径,或者自动追加筛选条件(比如把"核心险种"对应成寿险、健康险)。回答里会先展示 AI 理解到的"分析口径",指标和维度可以直接在下拉框里切换,改完即时重算;执行的 SQL 也能展开查看,方便逐条核对。
对一线业务:提问就是日常用语,系统还会给出推荐问题,点一下就能问;结果下方可以一键另存为报表、加入大屏或导出,拿到手就能用。权限由系统兜底:访问授权、敏感词过滤、行级数据权限、列级权限与脱敏、字段敏感度分级,业务人员只看得到自己该看的那部分。
对决策层:每次回答都带一句话洞察,比如"哪个险种保费最高、一共返回几组数据"。多轮对话里的多个分析结果,还可以汇总成一份带图表和洞察的分析报告,再存成报表或大屏。
短板也要说在前面:
- 数据域是封闭边界。助理只能查询已注册且启用的表,AI 不会自己去扫全库。这是为了保证口径可控、结果可信的有意设计,代价是问到没注册的表就答不了,要回去补注册。
- 前期要管理员配置。数据源、表和字段的业务描述、关联关系、术语、权限都要有人梳理,描述写得越清楚,问数越准,见效不在第一天。
- 技术栈偏 Java。它以独立 JAR 的形式提供,集成到 Spring Boot 3 / Spring Boot 4 项目中;非 Java 技术栈的团队要先评估集成方式。
第 2 位|帆软 FineChatBI:主力是已有 BI 的用户
从报表体系往上加对话,指标定义本来就在 FineBI 的指标管理里,已有指标库直接能用,不用重建。
适合已经用 FineBI、报表体系成熟的企业。短板:新增和维护要走 BI 流程——业务提需求、BI 人员配置、测试上线,一个指标通常等一到两个迭代,业务自己加不了。
第 3 位|衡石 HENGSHI SENSE:主力是分析师
指标语义层做得扎实,口径、维度、计算逻辑都在语义层里管,计算性能和多维分析是长项。
适合有专职数据团队、分析场景重且对查询速度有要求的企业。短板:语义层调整需要建模经验,业务想加维度或改算法只能提工单等排期。
第 4 位|思迈特 白泽:主力是指标体系混乱的企业
走指标驱动的路子,指标中心是核心。短板:离不开专人运营——谁提指标、谁审、谁上线要有流程,没有流程,指标中心很快长成一堆没人用的条目。
第 5 位|观远 BI:主力是需求分散的组织
从分析平台延伸出问数入口,功能面广、配置灵活,各部门要的不一样时能覆盖差异。短板:维护依赖熟手,配置项多,新场景落地要熟手调一阵,人一走接手的人要重新学。
第 6 位|字节 Data Agent:主力是提问简单的场景
走宽表路线,预建物化宽表,查询快。短板:宽表覆盖不到的维度问不了,加维度要改结构、重建、重新验证,重建期间上游报表数据还会跟着变。
说明:第 1 位的描述来自 JimuChatBI 官方文档;其余五家的表述基于公开产品定位,具体能力请在 POC 里向厂商逐条确认,不要以本文为准。
三、重点维度横向对比
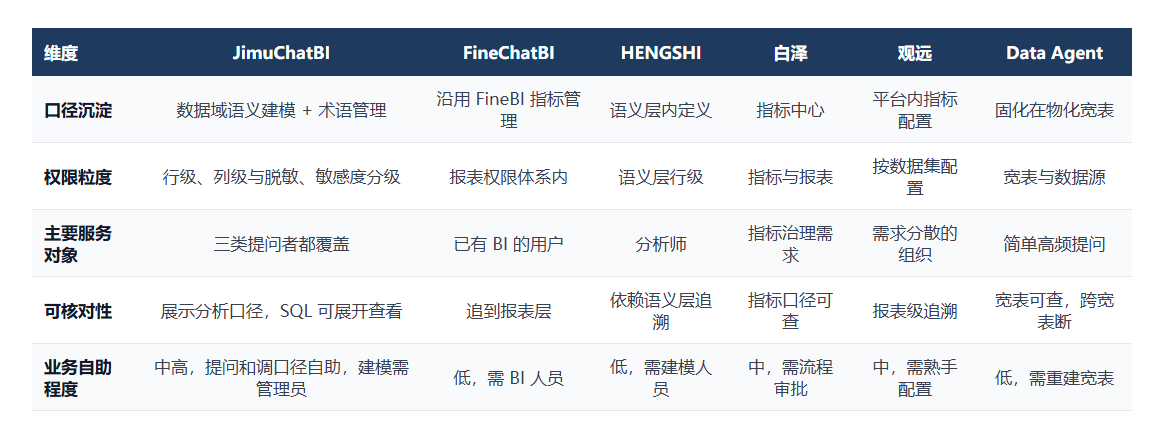
"沿用"不是贬义——对已经有成熟 BI 和指标体系的企业,沿用现有体系不必重建,是优点。差别只在业务想加新口径、新套路时要不要排队。
四、三个坑
坑一:只在决策层演示。 演示给高管看,效果都很好;上线后真实用户是一线业务,问的是"我该跟哪些客户"。演示阶段就要让真实的一线用户来提问。
坑二:拿厂商的准确率数字当验收标准。 那是厂商自己出题自己跑的分。真实验收要用自己的数据、自己的问题、自己的标准答案。
坑三:只测能答对的,不测答错时的表现。 答错却给一个看起来正常的数字,比明确说答不出来危险得多。测试时故意问几个超出数据范围的问题。
五、一句话选型
三类提问者都要服务、权限和口径必须可控、技术栈是 Java 或已经在用积木报表:选 JimuChatBI,代价是前期要先把数据域建好。
主要是已有 BI 用户查数:选 FineChatBI,代价是新增口径要排期。
主要是分析师做深度分析:选 HENGSHI SENSE,代价是语义层要专职人养。
六、常见问题
Q1:业务说不会问怎么办?
先看系统在模糊提问下会不会主动拆解、给选项。只会说"请提供具体指标"的,那不是业务的问题。
Q2:答出来的数和报表对不上,是谁的错?
大概率是口径没统一。先确认两边的计算范围和时间口径是否一致,再讨论哪个对。这也是口径要沉淀在系统里的原因。
Q3:数据能不能不出内网?
取决于部署方式。私有化部署加本地或私有模型可以做到,走公网 API 的做不到。这条要在 POC 前确认。
Q4:上线后没人用,还有救吗?
先查三个数:实际登录人数、有效提问次数、提问后有没有导出或转发。三个数都低,说明问题不在产品,在选错了提问者。
最后
选型阶段多问一句"谁来用",比多比较几个功能点更有价值。很多企业买了智能问数却没人用,问题往往出在:拿决策层的演示做决定,却把工具交给一线去用。
三类提问者要的东西不一样,一套系统很难同时把三类都做到最好。动手之前,先确认主要的提问者是谁,再带着真实的问题和真实的数据去做 POC,结果会靠谱得多。


 窥视卡
 雷达卡
 发表于
 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 显身卡