JimuReport积木报表这次针对大数据量导出做了一轮优化,覆盖 Excel、PDF、Word 三种格式。下面用 10 万行数据的实测结果,说明优化了什么、提升了多少。
测试条件
- 数据量:10 万行明细,9 列(另测了 50 万行)
- 报表:不分组明细、两级分组(带小计 / 合计)、带 5 个表达式列的明细
- Excel 分 sheet:每个 sheet 最多 20 万行(
excelSheetMaxRows),10 万行导出为 1 个 sheet
- 环境:JDK 17,堆内存 4G
- 正确性:优化前后的导出结果逐行、逐页比对,内容一致
提升一:带表达式的报表快约 3 倍,不再内存溢出
报表里用了 ROUND、CONCAT、if/else 这类单元格表达式时,10 万行导出:
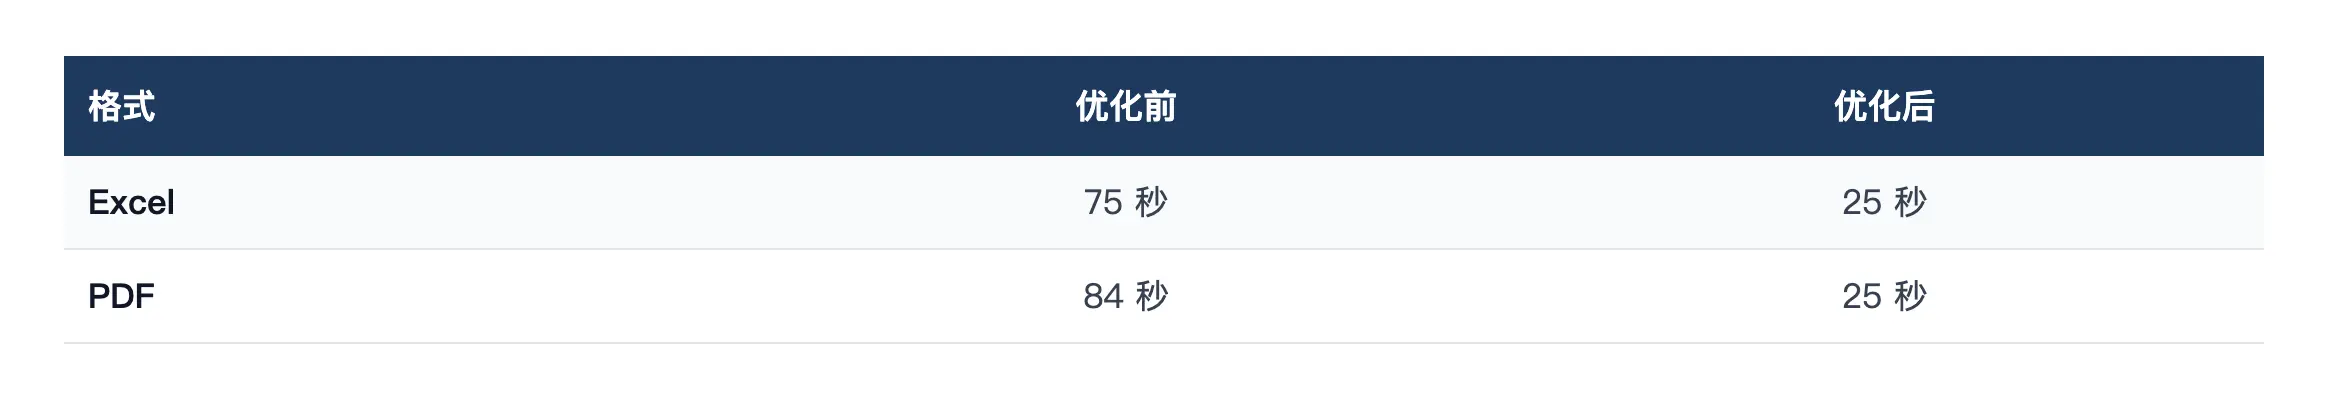
原来每一行的表达式都会被编译成一个新的 Java 类,10 万行就是几十万个类,会把 JVM 的类空间(默认 1GB,和堆大小无关)撑满,导致内存溢出,内存再大的机器也会出现。现在改为解释执行,不再生成类,类空间占用从 1.87GB 降到约 100MB。
提升二:PDF 导出快一倍多,内存峰值降到 1/3
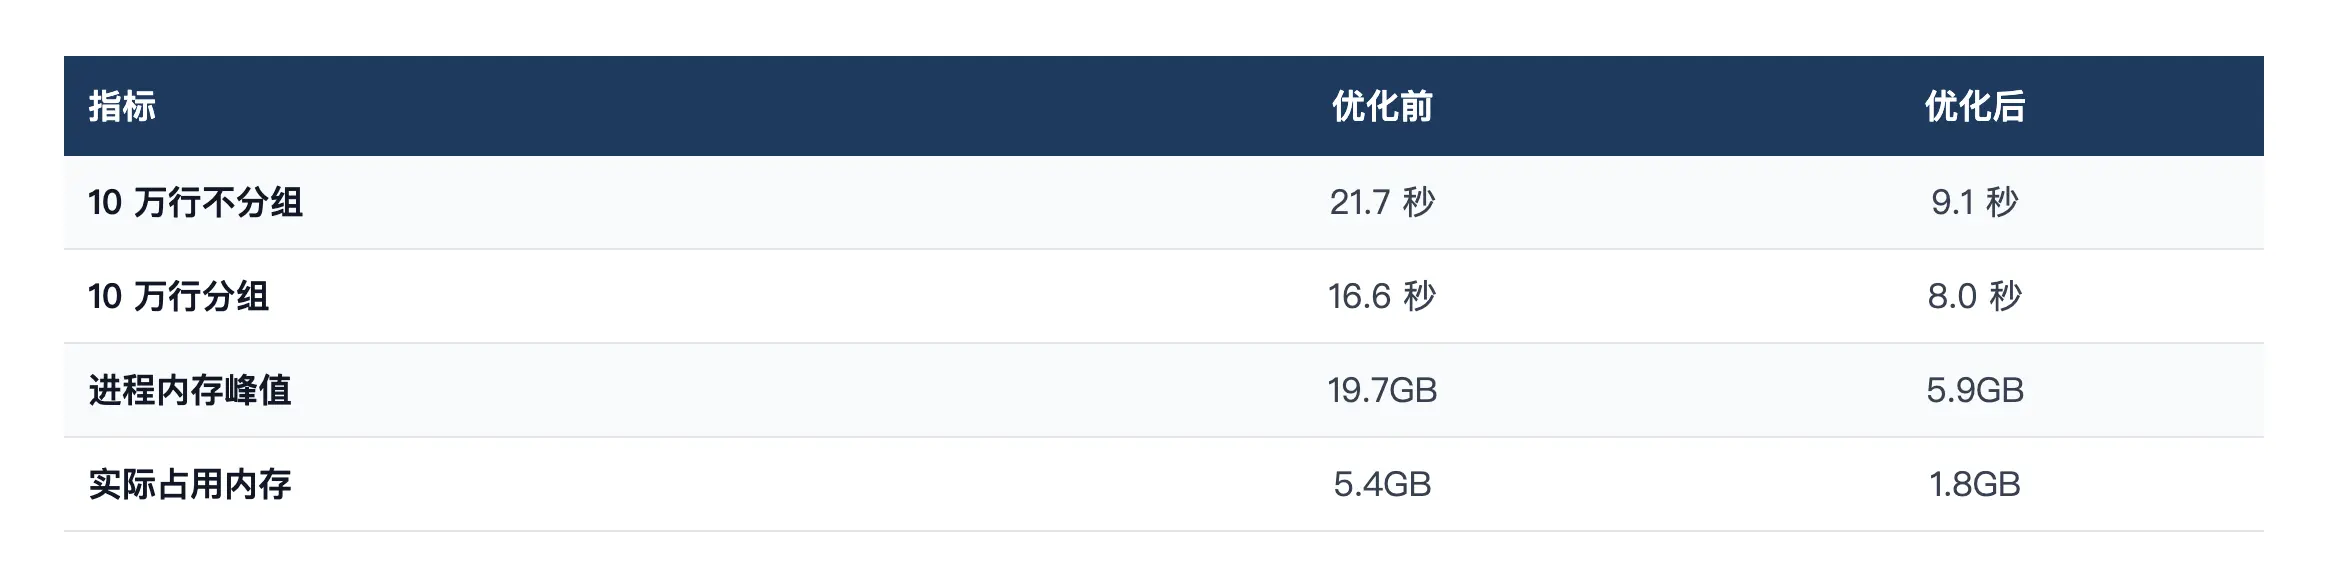
原因是导出时每个单元格都会重复做一些本可以只做一次的事:取字体时每次都抛出并吞掉一个异常、反复解析颜色、反复编译正则。改成只做一次并缓存结果后,速度和内存都明显改善。
提升三:8G 内存的服务器也能稳定导出 10 万行
按实际部署方式(4G 堆)测试,优化后:
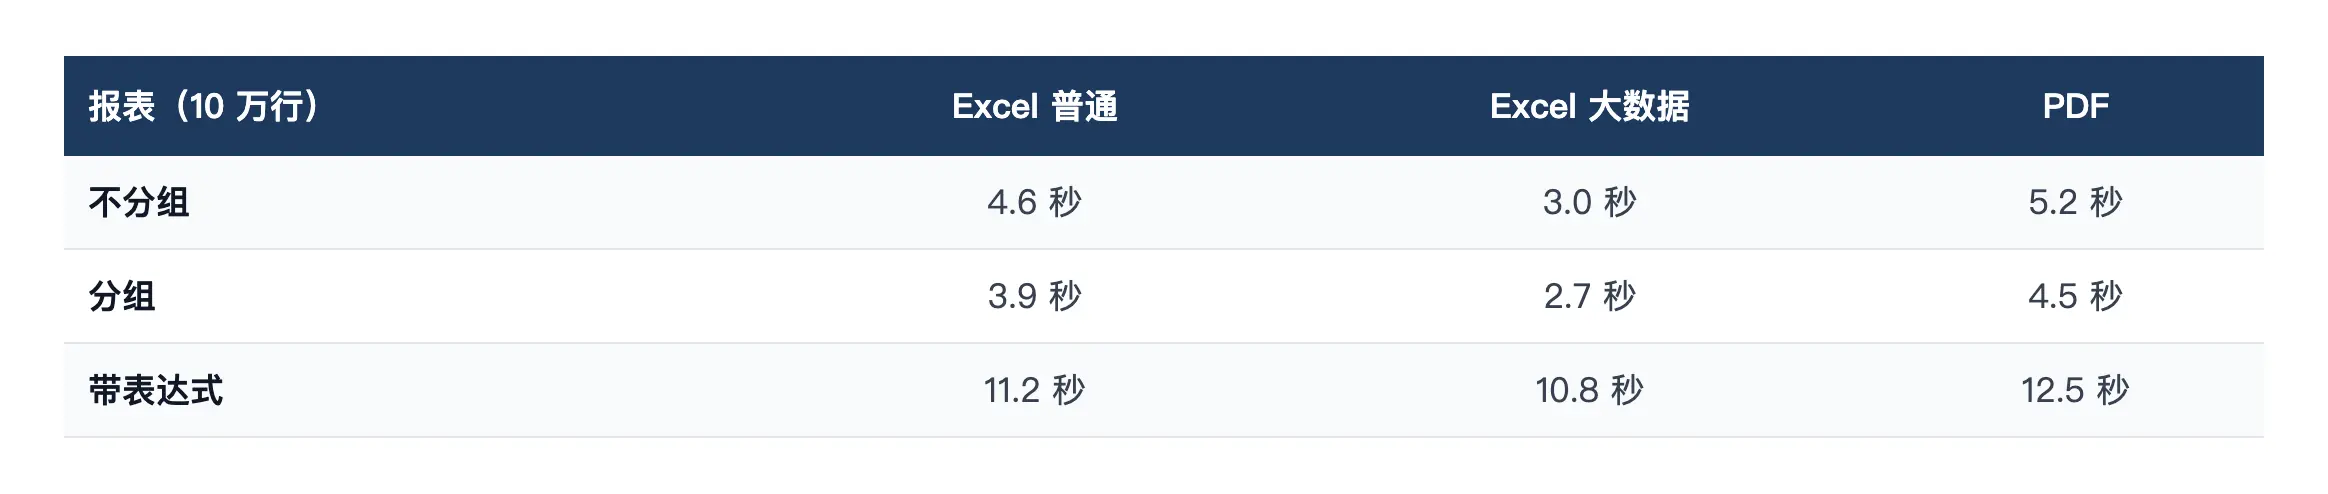
3 个导出同时进行也全部成功。
提升四:带二维码 / 条形码的导出文件体积缩小 90% 以上
- 文件体积大幅缩小:一份带大量二维码的导出文件,从约 200MB 降到十几 MB。
- 二维码、条形码生成速度提升约 10 倍。
- 显示更清晰、不变形:二维码不再变形,条形码不再拉伸,放大和打印更清晰;预览、打印、导出 Excel / Word / PDF 显示效果一致。
- 大数据导出模式下,二维码和条形码的位置不再错位。
- 预览页导出「PDF 图像」时,数据量大会先提示改用后端导出,避免浏览器卡死。
其他改进
- Excel 导出:判断单元格是否为公式时不再逐格编译正则,整体快 5~10%,50 万行不分组 4G 堆约 15 秒导完。
- Word 导出:分页计算不再每行重复读取纸张设置,快 6~10%。
- 多图表报表:25 个图表的报表导出 PDF、Excel、Word 都在 2~3 秒内完成。
- PDF 横向:报表打印设置选横向(
layout: landscape)即可,A4 横向能放下更多列。
导出参数配置
在 application.yml 中配置(以下均为默认值,按需调整):
jeecg:
  jmreport:
    # Excel 导出每个 sheet 的最大行数,超出自动分 sheet(默认 60000)
    # 导出 xls 时不要超过 65536
    excelSheetMaxRows: 60000
    # 导出 PDF、Word 的最大数据行数,超出会提示减少导出数据量(默认 10000)
    exportMaxDataRows: 10000
    # 不分页数据集一次最多查询的行数(默认 100000),分组报表、打印全部受此限制
    maxDataRows: 100000
excelSheetMaxRows 是新参数名,旧参数 pageSizeNumber 仍然兼容,两个都配置时以新参数为准。exportMaxDataRows 只控制 PDF、Word,修改它不影响 Excel 分 sheet。- 调大
exportMaxDataRows 前请确认堆内存足够:PDF、Word 是整份文档在内存中生成,数据量越大越吃内存,Word 比 PDF 更明显,多人同时导出时按份数叠加。
部署建议
- 8G 内存的服务器,JVM 堆设为
-Xmx4g 即可满足 10 万行导出。
- 建议加上
-XX:SoftRefLRUPolicyMSPerMB=0,让表达式相关的缓存对象及时回收。
- Word 导出条数上限建议保持默认 1 万(
exportMaxDataRows),大数据量请导出 Excel。
本文为 JimuReport AI 专题研究系列文章。 | 


 窥视卡
 雷达卡
 发表于
 提升卡
 置顶卡
 沉默卡
 喧嚣卡
 变色卡
 千斤顶
 显身卡